¿Cuánta agua gasta la IA? ChatGPT vs Claude vs Gemini (2026)
Artículo generado con IA. Las cifras y referencias normativas enlazan a fuentes primarias.
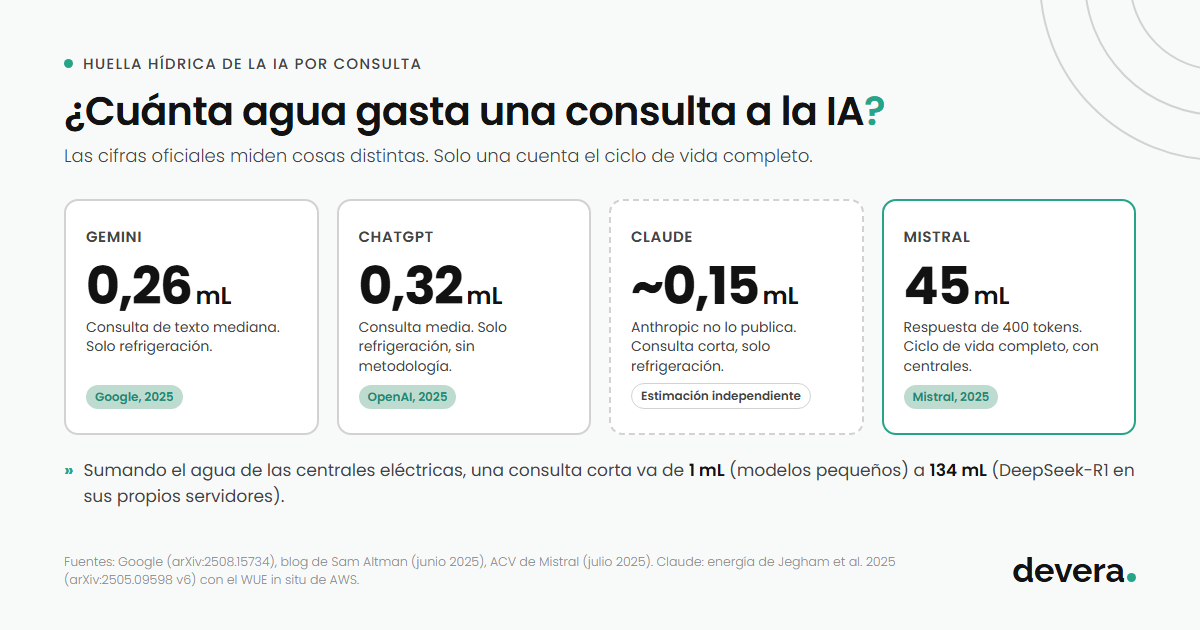
¿Cuánta agua gasta la IA? Según las propias empresas, una consulta típica de ChatGPT consume unos 0,32 mL de agua y una consulta mediana de Gemini 0,26 mL, más o menos cinco gotas. Esas cifras solo cuentan el agua de refrigeración dentro del centro de datos. Si se suma el agua que se usa para generar la electricidad, un benchmark independiente de 30 modelos sitúa una consulta corta de GPT-4o en unos 2 mL y Claude 3.7 Sonnet en unos 5 mL, mientras que DeepSeek-R1 en los servidores propios de DeepSeek llega a 134 mL. A continuación comparamos el agua, la energía y el CO2 por consulta de ChatGPT, Claude, Gemini, DeepSeek, Mistral y Llama, explicamos por qué las cifras publicadas varían tanto y repasamos cómo gestionan sus centros de datos los grandes proveedores cloud.
Puntos clave
-
Las cifras oficiales de agua solo cuentan la refrigeración. Google declara 0,26 mL por consulta mediana de Gemini y el CEO de OpenAI 0,32 mL por consulta media de ChatGPT. Si se cuenta el agua de las centrales eléctricas, la cifra se multiplica aproximadamente por 10 a 30.
-
Anthropic no publica cifras por consulta de Claude. El mejor dato independiente sitúa una consulta corta de Claude 3.7 Sonnet en 0,95 Wh, unos 0,15 mL de agua de refrigeración y 5 mL contando la generación eléctrica.
-
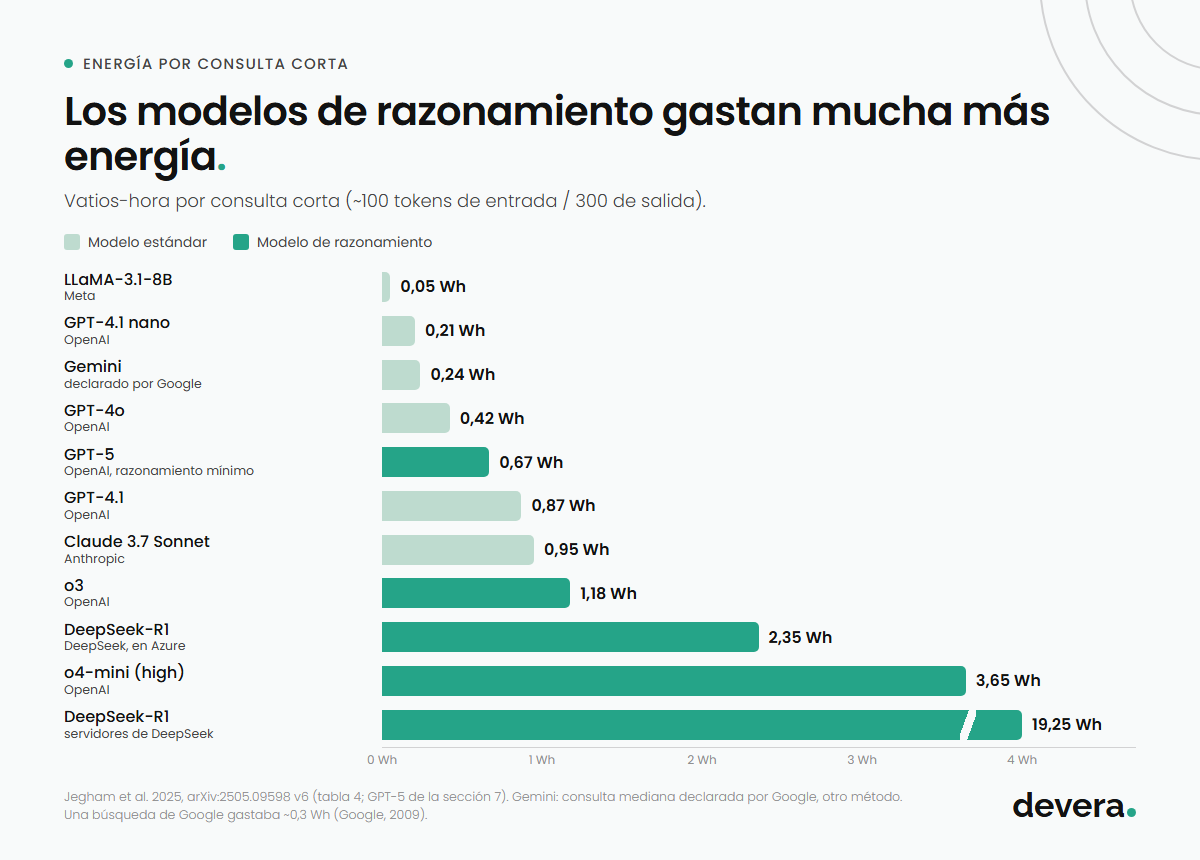
Los modelos de razonamiento gastan mucho más. Por consulta corta, o4-mini (high) consume unas 9 veces la energía de GPT-4o y DeepSeek-R1 en los servidores de DeepSeek unas 45 veces. GPT-5 con razonamiento alto llega a 33,8 Wh en una consulta larga.
-
La diferencia entre modelos supera las 300 veces, de 0,05 Wh (LLaMA-3.1-8B) a 19,3 Wh (DeepSeek-R1) por consulta corta. Elegir el modelo es en sí una decisión de sostenibilidad.
-
Dónde se ejecuta el modelo importa tanto como el modelo. El mismo DeepSeek-R1 consume 2,4 Wh en Azure y 19,3 Wh en la infraestructura propia de DeepSeek, con unas 14 veces más CO2.
-
El problema real es la escala. La IEA prevé que el consumo eléctrico de los centros de datos pase de 415 TWh en 2024 a unos 945 TWh en 2030, con la IA como principal motor.
¿Cuánta agua gasta la IA por consulta?
Solo tres empresas de IA han puesto cifra al agua que consume una consulta, y cada una la mide con un perímetro distinto:
| Asistente de IA | Agua por consulta | Energía por consulta | Qué incluye la cifra | Fuente |
|---|---|---|---|---|
| Gemini (Google) | 0,26 mL | 0,24 Wh | Consulta de texto mediana en Gemini Apps, mayo de 2025. Solo agua de refrigeración del centro de datos | Google, arXiv:2508.15734 |
| ChatGPT (OpenAI) | ~0,32 mL (0,000085 galones) | 0,34 Wh | ”Consulta media”, dada en un post de blog sin metodología | Sam Altman, junio de 2025 |
| Le Chat (Mistral Large 2) | 45 mL | n/d | Respuesta de 400 tokens, ciclo de vida completo: incluye la generación eléctrica y una parte del entrenamiento y del hardware | Mistral, julio de 2025 |
| Claude (Anthropic) | No publicado | No publicado | Sin cifra por consulta ni de su flota a noviembre de 2026 | Ver la sección de Claude más abajo |
La diferencia de 170 veces entre Gemini y Mistral no se debe a que Mistral gaste tanta más agua. Es sobre todo una cuestión de perímetro:
- Agua in situ es la que evapora el centro de datos en sus torres de refrigeración. Es lo que declaran Google y OpenAI.
- Agua fuera del centro es la que consumen las centrales que producen la electricidad. En una red eléctrica típica de EE. UU. es mucho mayor que la parte in situ.
- Agua de ciclo de vida añade además una parte del entrenamiento del modelo y de la fabricación de chips y servidores. Es lo que declara Mistral.
Ninguna es incorrecta, pero no se pueden comparar directamente. Un análisis de ciclo de vida completo es la única forma de ponerlas en la misma base, la misma lógica que aplicamos a los productos físicos en una huella de carbono de producto.
¿Qué IA gasta menos agua?
Para comparar modelos en la misma base usamos la fórmula de agua y los parámetros de centro de datos del benchmark independiente más completo, Jegham et al., “How Hungry is AI?” (v6, noviembre de 2025). Cuenta la refrigeración in situ más el agua consumida al generar la electricidad, con el PUE y la eficiencia hídrica (WUE) publicados por cada proveedor.
| Modelo (consulta corta*) | Energía (Wh) | Agua in situ (mL) | Agua total con generación eléctrica (mL) |
|---|---|---|---|
| GPT-4.1 nano (OpenAI, Azure) | 0,21 | 0,06 | 1,0 |
| LLaMA-3.3 70B (Meta, AWS) | 0,24 | 0,04 | 1,2 |
| GPT-4o (OpenAI, Azure) | 0,42 | 0,11 | 2,0 |
| GPT-4.1 (OpenAI, Azure) | 0,87 | 0,23 | 4,0 |
| Claude 3.7 Sonnet (Anthropic, AWS) | 0,95 | 0,15 | 5,0 |
| o3 (OpenAI, Azure) | 1,18 | 0,32 | 5,4 |
| DeepSeek-R1 (en Azure) | 2,35 | 0,63 | 10,9 |
| o4-mini high (OpenAI, Azure) | 3,65 | 0,98 | 16,9 |
| DeepSeek-R1 (servidores de DeepSeek) | 19,25 | 18,19 | 134,0 |
* Consulta corta: ~100 tokens de entrada y 300 de salida. Energía de la tabla 4 del estudio. Agua calculada con su fórmula, agua = (energía / PUE) x WUE in situ + energía x WUE fuera del centro, y sus parámetros: Azure PUE 1,12, 0,30 y 4,35 L/kWh; AWS PUE 1,14, 0,18 y 5,11 L/kWh; DeepSeek PUE 1,27, 1,20 y 6,016 L/kWh. Gemini no está en el benchmark.
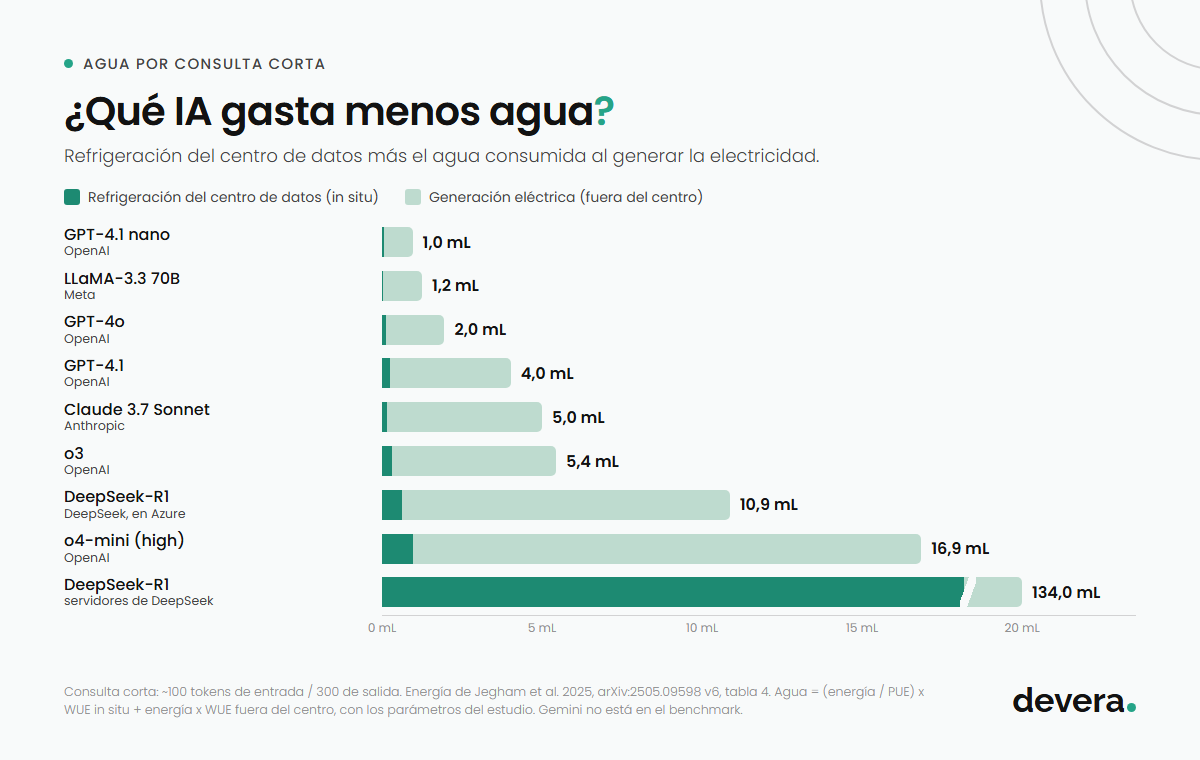
La respuesta depende de qué se cuente. Solo con el agua in situ, las opciones más ligeras son los modelos pequeños (GPT-4.1 nano, Llama) y la cifra que Google declara para Gemini, todas entre 0,04 y 0,26 mL. Contando la generación eléctrica, los modelos pequeños se quedan por debajo de 1,5 mL por consulta, mientras que los modelos de razonamiento y la infraestructura ineficiente suben a decenas o cientos de mililitros. Como Google solo publica la cifra in situ, no hay un dato independiente y comparable del agua total de Gemini.
¿Cuánta agua y energía gasta Claude?
Anthropic no ha publicado datos de energía, agua ni emisiones por consulta de Claude, y tampoco hemos encontrado datos de su flota. Cualquier cifra de Claude que veas en internet, incluida la nuestra, es una estimación independiente.
La estimación más rigurosa sale del mismo benchmark, que midió tres modelos de Claude ejecutados en AWS:
| Modelo de Claude | Consulta corta (Wh) | Consulta media (Wh) | Consulta larga (Wh) |
|---|---|---|---|
| Claude 3.7 Sonnet | 0,95 | 2,99 | 5,67 |
| Claude 3.5 Sonnet | 0,97 | 3,64 | 7,77 |
| Claude 3.5 Haiku | 0,98 | 4,46 | 8,01 |
Media: ~1k tokens de entrada y 1k de salida. Larga: ~10k de entrada y 1,5k de salida. Fuente: arXiv:2505.09598, tabla 4.
Con los parámetros de AWS, una consulta corta a Claude 3.7 Sonnet supone unos 0,15 mL de agua in situ, en el mismo rango que los 0,26 mL que Google declara para Gemini y los 0,32 mL que OpenAI declara para ChatGPT. Contando la generación eléctrica son unos 5 mL por consulta corta, 16 mL por una media y 30 mL por una larga. Su huella de carbono es de unos 0,27 g CO2e por consulta corta con la intensidad de 0,287 kg CO2e/kWh que el estudio usa para AWS. Amazon declara un WUE global de sus centros de datos de 0,15 L/kWh en 2024, algo mejor que los 0,18 L/kWh del estudio.
Dos salvedades. Primero, son modelos de 2025: la generación Claude 4 no se ha medido de forma independiente. Segundo, las mediciones se hacen a través de las APIs públicas, así que incluyen la latencia de red y no ven el hardware real de Anthropic.
¿Es Claude mejor para el medio ambiente que ChatGPT?
Por consulta, no: una consulta corta a Claude 3.7 Sonnet consume unas 2,2 veces la energía de una consulta corta a GPT-4o (0,95 frente a 0,42 Wh). Por unidad de resultado útil, el panorama cambia. El ranking de ecoeficiencia del estudio, que pondera el rendimiento en benchmarks frente a energía, agua y carbono, sitúa a Claude 3.7 Sonnet tercero de 28 modelos (0,825), justo por delante de GPT-4o (0,789) y por detrás de o3-mini (0,884) y o1-mini (0,836). Para la mayoría de usuarios, la palanca grande no es Claude frente a ChatGPT, sino el modo estándar frente al de razonamiento y las consultas cortas frente a las largas.
¿Cuánta energía usa realmente la IA?
El informe Energy and AI de la Agencia Internacional de la Energía estima que los centros de datos consumieron unos 415 TWh de electricidad en 2024, alrededor del 1,5 % del consumo mundial. En su escenario base esa cifra se duplica con creces, hasta unos 945 TWh en 2030, con los servidores acelerados para IA como principal motor. Estados Unidos, China y Europa concentran la mayor parte de la demanda.
Este crecimiento lo impulsan GPUs muy intensivas en energía. Una sola Nvidia H100 consume hasta 700 vatios, y un nodo de ocho GPUs puede alcanzar 5,6 kW. Los racks completos de cómputo de IA pueden superar los 240 kW, lo que obliga a rediseñar la refrigeración y el suministro eléctrico de las salas de datos.
¿Cuánta energía y carbono consume una consulta de IA?
El benchmark de Jegham et al. (arXiv:2505.09598) midió 30 modelos con consultas cortas, medias y largas. La dispersión es enorme: LLaMA-3.1-8B necesita solo 0,05 Wh para una consulta corta, mientras que DeepSeek-R1 en los servidores propios de DeepSeek necesita 19,3 Wh, más de 300 veces más. Google declara 0,24 Wh por consulta de texto mediana de Gemini y una reducción de 33 veces en la energía por consulta en los 12 meses anteriores. Los modelos de razonamiento (serie o, DeepSeek-R1, GPT-5 con razonamiento alto) consumen mucho más porque generan largas cadenas de pensamiento internas antes de responder.
Ejecutar el modelo: energía por consulta del usuario
| Modelo | Consulta corta* (Wh) | Consulta media** (Wh) | Consulta larga*** (Wh) |
|---|---|---|---|
| LLaMA-3.1-8B (Meta) | 0,05 | 0,17 | 0,44 |
| LLaMA-3.2 1B (Meta) | 0,11 | 0,34 | 0,55 |
| GPT-4.1 nano (OpenAI) | 0,21 | 0,58 | 0,83 |
| LLaMA-3.3 70B (Meta) | 0,24 | 0,76 | 1,45 |
| Gemini (Google, consulta mediana) | 0,24 | n/d | n/d |
| GPT-4o (OpenAI) | 0,42 | 1,22 | 2,88 |
| GPT-4.1 mini (OpenAI) | 0,45 | 1,55 | 2,12 |
| o1-mini (OpenAI) | 0,54 | 1,55 | 2,32 |
| GPT-4o mini (OpenAI) | 0,58 | 1,90 | 3,10 |
| o3-mini (OpenAI) | 0,67 | 2,42 | 3,53 |
| DeepSeek-V3 (en Azure) | 0,74 | 2,17 | 3,70 |
| GPT-4.1 (OpenAI) | 0,87 | 3,16 | 4,83 |
| Claude 3.7 Sonnet (Anthropic) | 0,95 | 2,99 | 5,67 |
| Claude 3.5 Sonnet (Anthropic) | 0,97 | 3,64 | 7,77 |
| Claude 3.5 Haiku (Anthropic) | 0,98 | 4,46 | 8,01 |
| o3 (OpenAI) | 1,18 | 5,15 | 12,22 |
| GPT-4 Turbo (OpenAI) | 1,70 | 5,94 | 9,88 |
| LLaMA-3.1-405B (Meta) | 2,23 | 9,04 | 25,20 |
| o1 (OpenAI) | 2,27 | 4,05 | 6,18 |
| DeepSeek-R1 (en Azure) | 2,35 | 4,33 | 7,41 |
| DeepSeek-V3 (servidores de DeepSeek) | 2,78 | 8,86 | 13,16 |
| o3-mini high (OpenAI) | 3,01 | 6,87 | 5,39 |
| o4-mini high (OpenAI) | 3,65 | 7,38 | 7,24 |
| DeepSeek-R1 (servidores de DeepSeek) | 19,25 | 24,60 | 29,08 |
* Corta: ~100 tokens de entrada → 300 de salida. ** Media: ~1k → 1k tokens. *** Larga: ~10k → 1,5k tokens. Fuente: arXiv:2505.09598 v6 (Jegham et al.), tabla 4, redondeado a dos decimales. Gemini según el blog de Google Cloud; el método de Google no es el mismo que el del estudio. El estudio también da cifras de GPT-5 fuera de su tabla principal: 0,67 Wh para una consulta corta con razonamiento mínimo, de 2,33 a 17,15 Wh para una media según el nivel de razonamiento y 33,8 Wh para una larga con razonamiento alto.
Huella de carbono: depende de dónde se ejecuta el modelo
El CO2 por consulta depende no solo de la energía sino de la intensidad de carbono de la electricidad de cada proveedor. El estudio usa valores específicos por proveedor en lugar de una media mundial:
| Infraestructura | Modelos | Intensidad de carbono (kg CO2e/kWh) | PUE |
|---|---|---|---|
| Microsoft Azure | OpenAI, DeepSeek (Azure) | 0,35 | 1,12 |
| AWS | Anthropic Claude, Meta Llama | 0,287 | 1,14 |
| Servidores propios de DeepSeek (China) | DeepSeek | 0,6 | 1,27 |
Multiplicando la energía por estas intensidades se obtiene el carbono por consulta corta:
| Modelo | Energía (Wh) | CO2e por consulta corta (g) |
|---|---|---|
| Gemini (declarado por Google) | 0,24 | 0,03 |
| LLaMA-3.3 70B | 0,24 | 0,07 |
| GPT-4.1 nano | 0,21 | 0,07 |
| GPT-4o | 0,42 | 0,15 |
| Claude 3.7 Sonnet | 0,95 | 0,27 |
| GPT-4.1 | 0,87 | 0,30 |
| o3 | 1,18 | 0,41 |
| DeepSeek-R1 (en Azure) | 2,35 | 0,82 |
| DeepSeek-R1 (servidores de DeepSeek) | 19,25 | 11,55 |
La cifra de Google es market-based: refleja sus compras de energía limpia, por eso es tan baja. Las demás usan medias de red. Si quieres entender por qué esta distinción importa tanto, mira nuestra guía sobre Alcance 2 market-based vs location-based.
Ranking de ecoeficiencia: rendimiento frente a coste ambiental
No todos los modelos pesados dan resultados proporcionalmente mejores. El estudio aplica un Análisis Envolvente de Datos de eficiencia cruzada (DEA), un método que puntúa cuánto rendimiento en benchmarks ofrece cada modelo por unidad de energía, agua y carbono:
| Puesto | Modelo | Puntuación de ecoeficiencia |
|---|---|---|
| 1 | o3-mini | 0,884 |
| 2 | o1-mini | 0,836 |
| 3 | Claude 3.7 Sonnet | 0,825 |
| 4 | GPT-4o | 0,789 |
| 5 | o3 | 0,758 |
| … | Modelos LLaMA | 0,4 a 0,6 |
| 27 | DeepSeek-R1 | 0,067 |
| 28 | DeepSeek-V3 | 0,059 |
Los modelos de razonamiento compactos (o3-mini, o1-mini) encabezan el ranking porque dan buenos resultados con un consumo moderado. Claude 3.7 Sonnet y GPT-4o les siguen de cerca. Al final, los modelos de DeepSeek ejecutados en sus propios servidores puntúan lo más bajo, porque a un consumo alto se suman una red eléctrica intensiva en carbono y una refrigeración que gasta mucha agua. Los mismos modelos alojados en Azure puntúan mucho mejor (0,52 a 0,54).
¿Cómo se comparan las consultas de IA con otros hábitos digitales?
OpenAI afirma que una consulta media de ChatGPT consume ~0,34 Wh, y el benchmark sitúa una consulta corta de GPT-4o en 0,42 Wh. Es un orden de magnitud parecido a los 0,3 Wh que Google dio para una búsqueda web en 2009, y muy por debajo del streaming de vídeo. Los modelos de razonamiento son otra historia.
Electricidad de acciones digitales comunes (10 unidades)
| Actividad | Energía (Wh) | Fuente |
|---|---|---|
| Búsqueda de Google x10 | 3,0 | Google, 2009 |
| ChatGPT x10 consultas (estándar)† | 3,4 a 4,2 | OpenAI / Jegham et al. |
| o3 x10 consultas cortas (razonamiento) | 11,8 | Jegham et al. |
| Streaming de vídeo x10 minutos | 12,8 | IEA, 2020 (0,077 kWh por hora) |
| GPT-5 con razonamiento alto x10 consultas medias | 171,5 | Jegham et al. |
† El rango refleja los 0,34 Wh de media de OpenAI frente a los 0,42 Wh del benchmark para GPT-4o.
Una sola consulta de IA consume poca energía, pero miles de millones de consultas diarias suman una demanda eléctrica considerable. Compararla con hábitos conocidos como buscar o ver vídeos ayuda a poner su huella en contexto para usuarios, legisladores y planificadores de infraestructura.
¿Y el entrenamiento? El gran impacto antes del despliegue
Entrenar grandes modelos fundacionales sigue siendo el evento puntual más intensivo en recursos del ciclo de vida de la IA. Aunque la inferencia domina el consumo total a escala, un solo entrenamiento puede consumir más electricidad de la que usan miles de hogares en un año.
Impacto del entrenamiento de algunos LLMs
| Modelo | Energía de entrenamiento | CO2 estimado | Agua de refrigeración |
|---|---|---|---|
| GPT-3 (175B parámetros, 2020) | 1.287 MWh | ~552 t CO2e | ~5,4 millones de L (incl. fuera del centro) |
| LLaMA-3-70B (70B parámetros, 2024) | 6,4 M horas de GPU (~4,5 GWh a 700 W) | 1.900 t CO2e (compensadas por Meta) | No publicado |
| GPT-4 (2023) | ~52-62 GWh (estimación de terceros) | ~12-15 kt CO2e (estimación) | Desconocido |
Fuentes: Patterson et al. (energía y CO2 de GPT-3), Li et al., “Making AI Less Thirsty” (agua de GPT-3), ficha del modelo Llama 3 de Meta. OpenAI no ha publicado cifras de entrenamiento de GPT-4 ni de modelos posteriores.
El entrenamiento ocurre con mucha menos frecuencia que la inferencia, pero cada nueva generación necesita más cómputo. Las mejoras de eficiencia del hardware (H100 frente a A100) solo compensan parte de ese crecimiento.
Agua: el coste oculto de la IA generativa
Los centros de datos consumen agua sobre todo para refrigerar los servidores, e indirectamente a través de las centrales que les suministran electricidad. A la escala de miles de millones de consultas al día, unas gotas por consulta se convierten en un problema regional, sobre todo donde los centros de datos se concentran en zonas con estrés hídrico.
Perspectiva global
Investigadores de UC Riverside (Li et al.) proyectan que la IA podría extraer de 4.200 a 6.600 millones de m³ de agua dulce en 2027, de los que de 380 a 600 millones de m³ se consumirían (evaporados). Esa extracción supera el total anual de cuatro a seis Dinamarcas.
Caso de estudio: Microsoft en West Des Moines
El campus de Microsoft en Iowa alcanzó un máximo de 11,5 millones de galones (~43 millones de L) en un mes de verano, alrededor del 6 % del consumo total de agua del distrito.
Respuesta corporativa
Los diseños más recientes de centros de datos de Microsoft usan refrigeración en circuito cerrado sin evaporación, que según la empresa evita más de 125 millones de litros por centro de datos al año.
Centros de datos: las guerras en la nube se vuelven verdes
Los cuatro principales hiperescalares Microsoft Azure, Amazon Web Services (AWS), Google Cloud y Meta presentan las estrategias de sostenibilidad más completas y medibles del mercado. Otros proveedores (Oracle Cloud, IBM Cloud, etc.) comparten objetivos similares pero publican menos métricas operativas o han fijado objetivos climáticos menos ambiciosos.
Comparemos a los principales hiperescalares por métricas de sostenibilidad.
Instantánea de sostenibilidad de los principales proveedores de IA/nube (2025)
| Proveedor | Meta de Carbono | Energía Renovable | PUE | Meta de Agua | WUE |
|---|---|---|---|---|---|
| Meta | Cero neto 2030 | 100% desde 2020 | 1.08 | Reponer 200% en áreas de alta presión | 0.20 L/kWh |
| Cero neto 2030 | 100% anualmente, 64% CFE 24/7 | 1.10 | Reponer 120% del agua | ~1 L/kWh | |
| Microsoft | Negativo en carbono 2030 | Objetivo 100% alcanzado en 2025 | 1.12 | Positivo en agua 2030 | ND (sin agua en nuevos diseños) |
| AWS | Cero neto 2040 | 100% desde 2023 | 1.15 | Positivo en agua 2030 (53% progreso) | 0.15 L/kWh |
Microsoft Azure
Hoja de ruta climática: Negativo en carbono, positivo en agua y cero residuos para 2030; objetivo de 100% electricidad renovable alcanzado en 2025.
Eficiencia operativa: PUE promedio de 1.12 en centros de datos de nueva generación, superando el promedio de la industria de 1.4–1.6.
Innovaciones: – Sistemas de enfriamiento sin agua e inmersión líquida que reducen las emisiones de GEI en un 15–21% y reducen el uso de agua en un 31–52%.
– Celdas de combustible de hidrógeno para una potencia de respaldo de cero emisiones de 3 MW.
Desafíos: A pesar de los diseños de ahorro de agua, el aumento en el consumo de agua en Texas ha generado oposición local.
Amazon Web Services (AWS)
Energía: Alcanzó la coincidencia total de electricidad renovable en 2023; objetivo de cero neto para 2040.
Eficiencia: PUE global de 1.15 (mejor sitio en 1.04).
Agua: Iniciativa Positiva en Agua para 2030; WUE global de 0.15 L/kWh (reducción del 40% desde 2021).
Innovaciones: – Uso de agua reciclada y proyectos de recarga de agua comunitaria; alcanzó el 53% de la meta de agua 2030 para 2024.
– Inversión en reactores nucleares modulares para descarbonizar la electricidad en regiones con baja energía renovable.
Desafíos: La fuerte dependencia de los Certificados de Energía Renovable (RECs) y el aumento de las cargas de trabajo de IA complican las reducciones reales de emisiones.
Google Cloud
Estrategia de “Energía Libre de Carbono 24/7 (CFE)”: Operar cada centro de datos con energía libre de carbono por hora para 2030; alcanzó el 64% a nivel global en 2024 (10 regiones en ≥90%).
Eficiencia: PUE promedio de 1.10; publica datos detallados a nivel de campus.
Agua: Compromiso para reponer el 120% del agua dulce consumida y mejorar las cuencas hidrográficas locales.
Innovaciones y desafíos: – Aseguró contratos de geotermia, batería y nuclear para apoyar las metas CFE 24/7.
– El crecimiento impulsado por la IA elevó la huella de agua en un 17% en 2023, generando preocupaciones de transparencia.
Meta (Facebook)
Energía: 100% renovable desde 2020; cero neto en toda la cadena de valor para 2030.
Eficiencia: PUE de 1.08 y WUE de 0.20 L/kWh; todas las instalaciones con certificación LEED Gold.
Agua: Devolver el 200% del agua en regiones de alta presión, 100% en regiones de presión media.
Innovaciones: Acuerdo geotérmico de 150 MW en New Mexico; exploración de micro-nuclear para cargas de trabajo de IA.
Desafíos: La discrepancia entre las emisiones basadas en ubicación y las basadas en el mercado plantea preguntas sobre el impacto real de los RECs.
Otros proveedores
Aspectos destacados de sostenibilidad clave
| Proveedor | Detalles de sostenibilidad |
|---|---|
| Oracle Cloud Infrastructure (OCI) | 100% renovables para 2025; cero neto para 2050; PUE de 1.30 en la región más eficiente. Utiliza captura de lluvia y xeriscaping para reducir la necesidad de agua. |
| IBM Cloud | 75% renovables para 2025 (90% para 2030), cero neto para 2030. Promueve energía solar en el sitio y gestión del agua a través de su Acelerador de Sostenibilidad. |
| Hiperescala/emergentes de colocación | El Pacto de Centros de Datos Climáticamente Neutrales de la UE apunta a PUE ≤ 1.3 y uso de agua < 2.5 L/kWh para 2025. Proveedores como Switch y CyrusOne ya despliegan sistemas de enfriamiento sin agua. |
Atributos clave de sostenibilidad de los Centros de Datos:
-
Microsoft y Google lideran con las hojas de ruta climáticas más agresivas (carbono negativo / CFE 24/7) e innovaciones en enfriamiento sin agua y energía de respaldo libre de carbono.
-
AWS destaca en despliegue rápido de renovables y fue el primero en lanzar un objetivo positivo en agua, aunque su meta de cero neto está fijada una década después (2040).
-
Meta ofrece las mejores relaciones operativas PUE-WUE y funciona completamente con renovables, pero su expansión explosiva de IA afecta el rendimiento de sostenibilidad.
-
Oracle, IBM y otros están progresando pero muestran menos transparencia y tienen objetivos a más largo plazo.
Impacto ambiental del ACV impulsado por IA con Devera
Cada huella de producto calculada con Devera evita horas de consultoría manual, reuniones innecesarias y viajes intensivos en carbono. Pero también desencadena:
- Normalmente entre 0,03M y 0,4M de tokens procesados por cada ACV.
- Varios minutos de computación de alta intensidad.
- Un pico breve pero real de consumo eléctrico en un centro de datos de AWS, donde se ejecutan los modelos Claude de Anthropic.
Eso es entre unas 3 y 35 veces el volumen de tokens de la consulta “larga” del benchmark (11,5k tokens, 5,7 Wh para Claude 3.7 Sonnet). Escalando de forma lineal, lo que sobrestima las cargas con mucha entrada, sale un orden de magnitud de 20 a 200 Wh por análisis: más o menos lo que gasta un portátil en una a cuatro horas. Puedes ver cómo se construye un análisis en cómo calcular la huella de carbono de un producto con IA.
Para ser claros, la huella de Devera es pequeña en comparación con los grandes laboratorios de IA, pero la dirección importa. Si no tenemos cuidado, podríamos terminar resolviendo problemas ambientales mientras contribuimos silenciosamente a otro.
Según nuestras suposiciones, un ACV de un consultor tradicional requiere más de 50 veces más energía que un ACV basado en IA con Devera, teniendo en cuenta la energía de estaciones de trabajo humanas, desplazamientos, infraestructura de oficina y el cronograma de varias semanas del análisis manual.

Preguntas Frecuentes
¿Cuánta agua gasta ChatGPT por consulta? El CEO de OpenAI, Sam Altman, situó una consulta media de ChatGPT en unos 0,000085 galones, alrededor de 0,32 mL o una quinceava parte de una cucharadita, sin publicar la metodología. Esa cifra solo cubre la refrigeración del centro de datos. Un benchmark independiente que también cuenta el agua usada para generar la electricidad sitúa una consulta corta de GPT-4o en unos 2 mL.
¿Qué IA gasta menos agua? Los modelos pequeños como GPT-4.1 nano o Llama 3.3 70B son los que menos gastan, de 1 a 1,2 mL por consulta corta contando la generación eléctrica y menos de 0,1 mL de agua de refrigeración. Entre los grandes asistentes, Google declara 0,26 mL de agua in situ por consulta mediana de Gemini, la cifra oficial más baja, aunque excluye el agua de las centrales. Los modelos de razonamiento y DeepSeek en sus propios servidores son los que más gastan, hasta 134 mL por consulta corta.
¿Cuánta agua gasta Claude? Anthropic no publica cifras de agua por consulta. A partir de mediciones independientes de energía de Claude 3.7 Sonnet (0,95 Wh por consulta corta) y de los parámetros de los centros de datos de AWS, una consulta corta gasta unos 0,15 mL de agua de refrigeración y unos 5 mL contando la generación eléctrica. Las consultas largas, con mucho contexto, gastan unas seis veces más.
¿Gasta Gemini menos agua que ChatGPT? Según las cifras oficiales, sí, ligeramente: 0,26 mL por consulta mediana de Gemini frente a unos 0,32 mL por consulta media de ChatGPT, ambas contando solo el agua de refrigeración. Google publicó su metodología y OpenAI no, así que la comparación es orientativa, no exacta.
¿Por qué varían tanto las estimaciones del agua que gasta la IA? Porque miden cosas distintas. Las cifras de las empresas suelen contar solo el agua evaporada en la refrigeración del centro de datos. Las estimaciones académicas suman el agua que consumen las centrales eléctricas, que a menudo es diez veces mayor, y los estudios de ciclo de vida como el de Mistral incluyen además el entrenamiento y la fabricación del hardware, hasta unos 45 mL por respuesta.
Conclusión: la IA está reformulando la ecuación de sostenibilidad
La huella ambiental de la IA es compleja, dinámica y sigue evolucionando. La eficiencia por consulta mejora rápido, con Google declarando una mejora de 33 veces en solo 12 meses, pero la escala de la demanda crece todavía más rápido. La diferencia de más de 300 veces entre los modelos más ligeros y los más pesados significa que elegir el modelo es en sí una decisión de sostenibilidad, una que desarrolladores, empresas y usuarios toman miles de millones de veces al día.
Los modelos de razonamiento como o3, o4-mini y DeepSeek-R1 han introducido un nuevo nivel de consumo energético, y GPT-5 con razonamiento alto puede superar los 30 Wh en una consulta larga. La infraestructura importa tanto como la arquitectura: DeepSeek-R1 en los servidores propios de DeepSeek emite unas 14 veces más CO2 por consulta que el mismo modelo en Azure.
La transparencia sigue siendo el gran hueco. Google publica una metodología, OpenAI una sola cifra, Mistral un análisis de ciclo de vida completo y Anthropic nada por consulta. Mientras cada proveedor no informe con la misma base, los benchmarks independientes son la mejor herramienta que tienen los usuarios.
Si la IA va a ser la nueva electricidad, entonces también debe seguir las mismas reglas: medida, monitorizada y descarbonizada en origen.